工具越强,越得知道哪儿不能去。
做运营的小周,每天上班第一件事:打开六个网页把数据抄进 Excel。抄完四十分钟。一年两百多工作日,一百六十多个小时花在”打开—选中—复制—粘贴”上。 他不是不会用电脑,是不知道这活能让电脑自己干。
但在动手前,我要先讲”哪些不能干”。爬虫是这个系列第一个”用错了会出事”的工具——前面写函数写页面顶多跑不通,这个可能违法。所以:先讲红线,再讲手法。
一、爬虫=自动化的复制粘贴
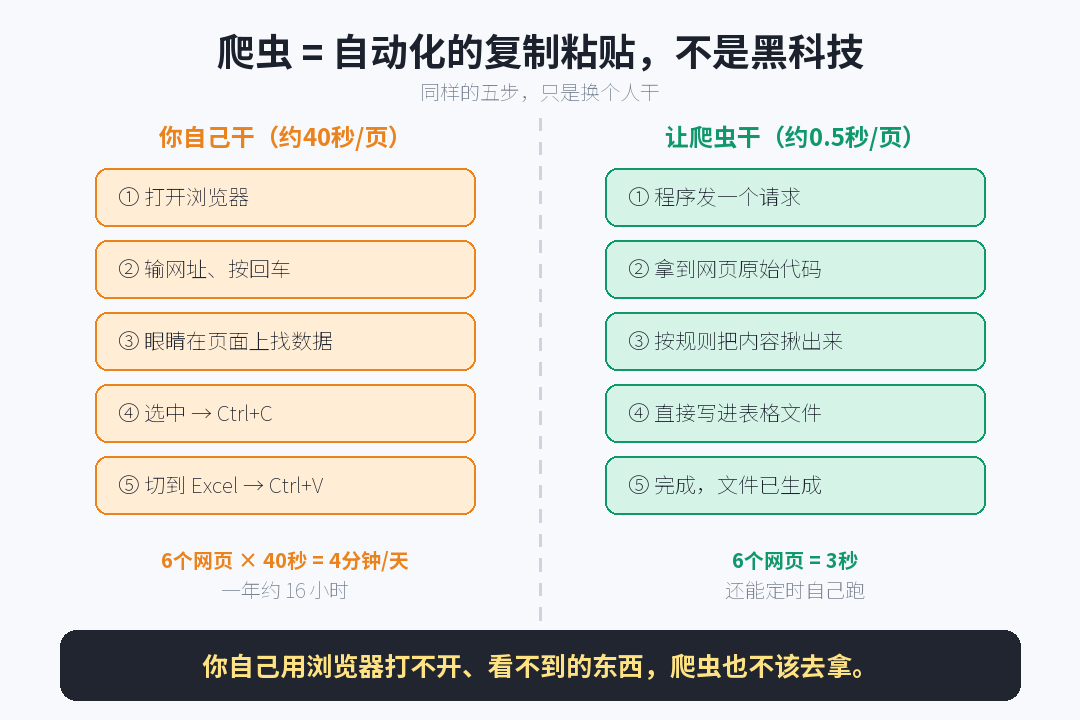
爬虫就是一段替你”打开网页+复制粘贴”的程序。
你平时打开网页抄数据,大致是五步:
- 输网址、回车;
- 看页面、找数据;
- 选中、Ctrl+C 复制;
- 切到 Excel 粘贴;
- 下一批,重复。
爬虫干的是一模一样的事,只是换成程序做后三步——发请求拿源码、按规则揪出数据、直接写进表格,一个网页约 0.5 秒,还能定时自己跑。
理解这点推出总纲:你自己用浏览器打不开、看不到的东西,爬虫也不该去拿。 这句话记一辈子。
二、红线:比后面所有技术都重要
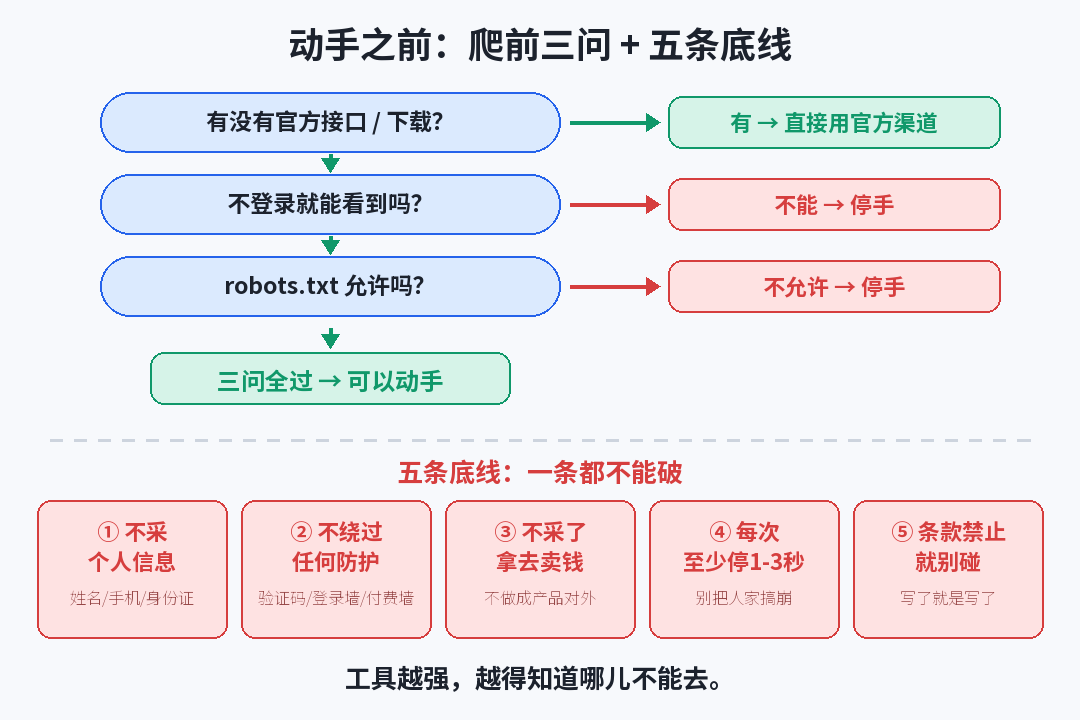
爬前三问(每次动手前背一遍)
- 有没有官方接口/下载? 能官方拿的绝不自己爬(很多网站右上角就有”导出 CSV”)。
- 不登录就能看到吗? 用无痕浏览器看得到→一般可采;要登录/付费/验证码→停。
- robots.txt 允许吗? 地址栏输”域名/robots.txt”看规矩,看不懂直接把全文贴给 AI 问。三问都过才动手,一条卡住就停。
五条底线(一条都不能破)
① 不采个人信息(姓名/手机/身份证/住址,法律层面); ② 不绕过任何防护(验证码、登录墙、付费墙); ③ 采来不拿去卖钱/做产品; ④ 每次请求至少隔 1~3 秒,别把人家网站搞崩; ⑤ 网站条款禁止的不碰。
最安全的入门练习:你自己搭的网站、官方开放的练习站点、政府公开数据页(且 robots.txt 允许)。
三、核心方法:采集需求四件套
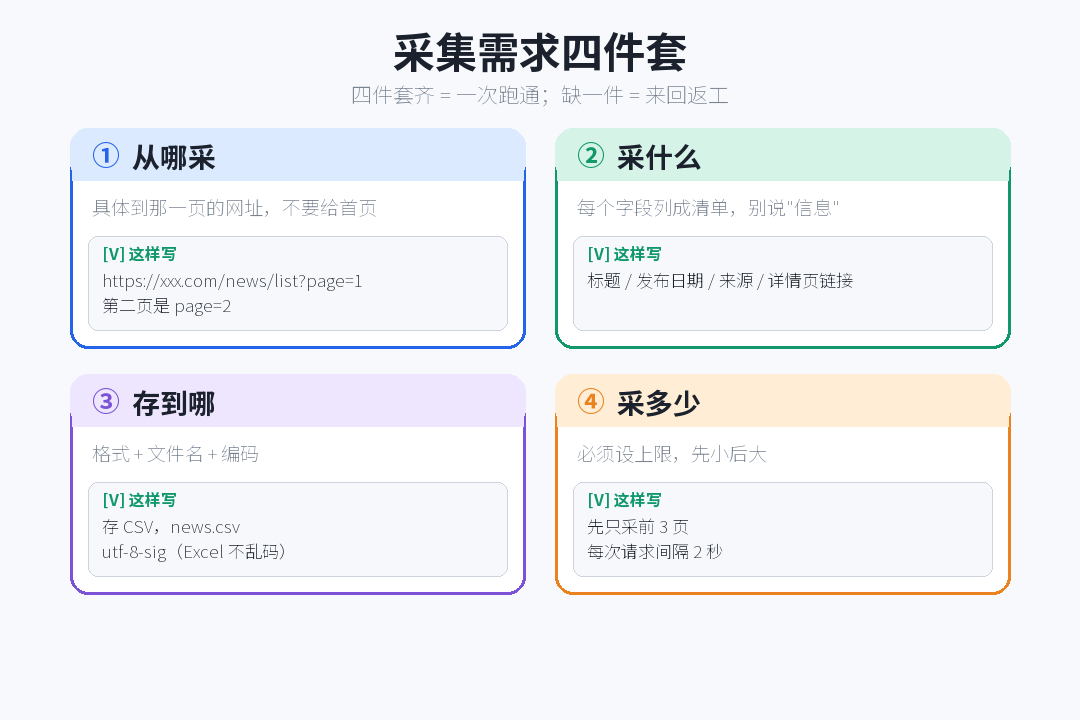
你不用学写爬虫,学把需求说清。四件套齐,AI 脚本一次能跑:
- ① 从哪采:给具体到那一页的网址,别给首页;分页说清翻页规律。
- ② 采什么:每个字段列成清单(标题/日期/来源/链接),你列几列表格就几列。
- ③ 存到哪:”存 CSV,文件名 news.csv,UTF-8-SIG 编码防 Excel 中文乱码”。
- ④ 采多少:先只采前 3 页、每次间隔 2 秒,跑通再放大。
四、实操:从零跑通第一个脚本
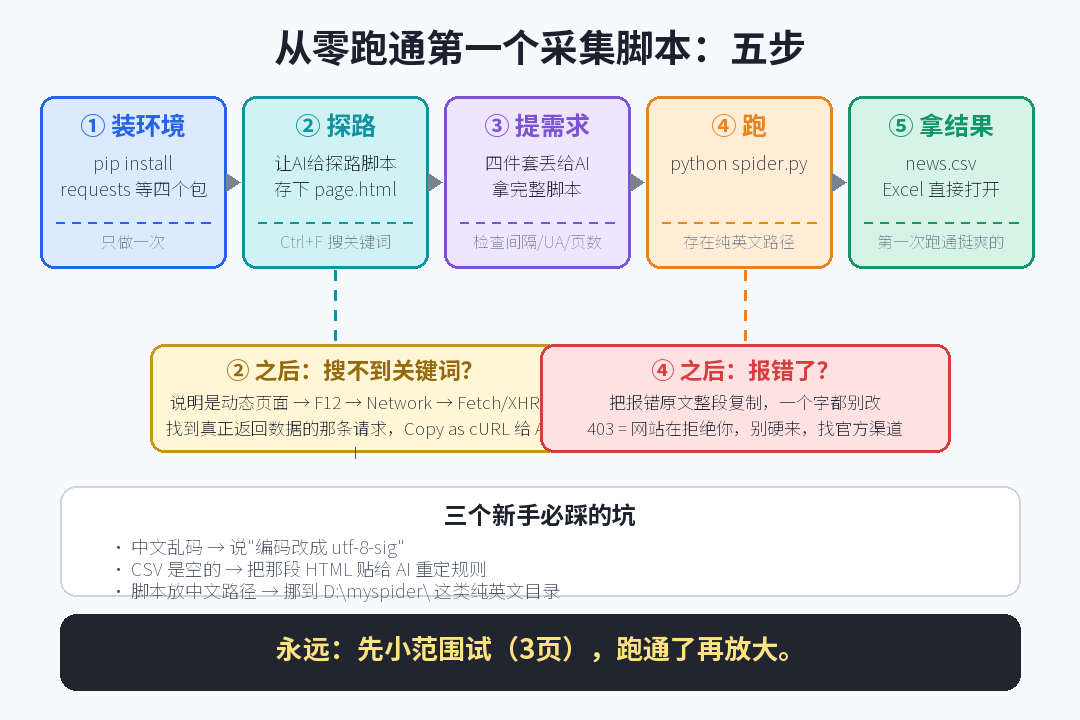
第一步装环境:python.org 下载,安装务必勾”Add Python to PATH”;pip install requests beautifulsoup4 pandas lxml(装一次以后都用)。
第二步探路:AI 打不开网页,先让它给段”探路脚本”存下 page.html,Ctrl+F 搜你要的新闻标题——搜得到是静态页(走第三步),搜不到是动态页(走本节末)。
第三步提需求:把四件套+页面那段 HTML 给 AI 拿完整脚本。你不用看懂每行,但扫三眼:有没有 time.sleep(2)(守规矩)、有没有 headers/User-Agent、页数上限对不对(只 3 页别 300 页)。
第四步跑:存 spider.py 到纯英文路径(如 D:\myspider),命令行 python spider.py,几秒多出 news.csv。
第五步不顺利:报错→贴原文别转述;CSV 空→贴那段 HTML 让 AI 重定规则;中文乱码→”编码改 utf-8-sig”;返回 403→网站在拒绝你,别硬来,回三问找官方渠道。
五、变 Excel / 动态页 / 定时跑
- 变 Excel:加一句”存 .xlsx、表头加粗、列宽自适应、已存在则追加新工作表”,再要”跑完打印新增 X 条跳过 Y 条”。
- 动态页搜不到关键词,按这几步探:
- 按 F12 → Network → Fetch/XHR;
- 找到返回数据的请求,右键 Copy as cURL 给 AI 改写。
注意判断:若请求 URL 本身带鉴权参数、或响应必须登录态才返回数据,那就是登录后数据,停手;否则只是带了个匿名会话 Cookie,前三问已通过就还能继续。找不到接口再用 playwright 让浏览器替你跑,兜底用。
- 每天自动跑,按这几步:
- 做
run.bat:两行——cd /d "D:\myspider"和python spider.py(cd /d是跨盘符也能进目录,少写这俩字常常跑不起来);存为.bat,先双击测一下能跑。 - Win 搜”任务计划程序” → 创建基本任务 → 每天 08:00 → 启动程序选
run.bat。
- 做
注意:电脑得开着;加日志写入 run_log.txt(防悄悄失败一个月);一天一次足够。
六、零代码替代 & 本地自动化
不想装 Python:网页是规整表格→Excel 数据→自网站;一次性→浏览器采集插件;每天自动跑/数据量大→Python 脚本+任务计划程序(唯一能定时自跑的路)。
别忘了”自动化”不止爬虫:合并 Excel、按日期归档、批量改名压缩、定时提醒邮件——同一套方法(说清+AI 出完整脚本+先小后大+加日志)。这些本地活完全没有爬虫红线顾虑,建议新手先练这个——既练手感又零风险,等手法稳了再碰外部采集。
提示词模板盒子
通用要求:我是编程新手,用 Windows;请当零基础每步说清;给完整可运行文件加中文注释;先判断合规再给代码。
模板一:先查合规(每次第一句)
我想采集这个网页公开数据:【网址】
动手前先判断:1)有无官方下载/开放接口,去哪找
2)下面 robots.txt 是否允许我要采的路径、有无访问间隔、其他限制:
   【粘贴,无则写"未找到"】
3)是否涉及个人信息/登录/付费。
任一条不合适请直接说"不建议采集"并给替代方案。中文回答,先别给代码。
模板二:采集主脚本(四件套完整版,最常用)
请用 Python 写完整可运行单文件。
【从哪采】具体网址+翻页规律
【采什么】字段清单:标题/日期/来源/链接
【页面依据】下面贴 page.html 里相关那段 HTML
【存到哪】CSV,result.csv,utf-8-sig 防乱码,首行中文表头
【采多少】先 3 页,time.sleep(2),超时 10 秒
【其他】带 User-Agent;某页失败不整体崩,打印继续;
       跑完打印汇总;关键处中文注释。给完整文件+pip 安装说明。
模板三:报错求助(万能)
我运行采集脚本出问题。
【报错原文】从第一行到最后一行整段粘贴
【环境】Windows/Python 3.x/路径
【期望】生成含 X 条 CSV 【实际】空文件/报错退出/乱码
请讲根本原因(大白话)、怎么改、给改好完整文件。
速查表
| 三问 | 通过条件 |
|---|---|
| 官方接口/下载? | 有→直接用官方 |
| 不登录能看到? | 能→继续;不能→停 |
| robots.txt 允许? | 允许→动手;否则→停 |
- 四件套:从哪采(具体网址) / 采什么(字段清单) / 存到哪(CSV+utf-8-sig) / 采多少(先3页+间隔2秒)。
- 五底线:不采个人信息、不绕防护、不卖钱、间隔1~3秒、条款禁的不碰。
下篇预告
这一篇你拿到两样:手法(四件套、探路、找接口、定时跑),和更重要的——分寸。从这篇起你手里的工具能对外部世界产生影响,能力越往上走越要知道边界。模块四”代码生成”八篇已走完七篇,方法论攒了一堆你可能已记不清。下一篇不学新东西,只干一件:把七篇方法论收拢成一套你能背下来的万能骨架。 第68篇:代码生成小结与提示词模板,建议看完专门存个笔记。