一个错都不报,结果就是不对。
上一篇讲的是”有红字”的 bug。
那一类其实是幸运的——程序已经明确告诉你出事了,还顺手指了地方。
这一篇讲的是另一类,也是真正吃时间的那一类:
程序跑得好好的,没有任何报错。 但结果就是不对。
统计出来的总数少了三条。 排序排完,第一名跑到了中间。 明明该显示 10 条,页面上只有 7 条。 金额算出来永远差那么几分钱。
没有红字,没有提示,你连从哪一行看起都不知道。
很多新手到这一步就卡死了,反复把整段代码丢给 AI,问一句:”帮我看看哪里有问题?”
然后 AI 开始一本正经地瞎猜。
这一篇,我们就把这类问题的正确打法讲透。
一、先理解:为什么 AI 对逻辑错更容易翻车
上一篇里,AI 表现得像个老手。这一篇,它经常表现得像个新手。
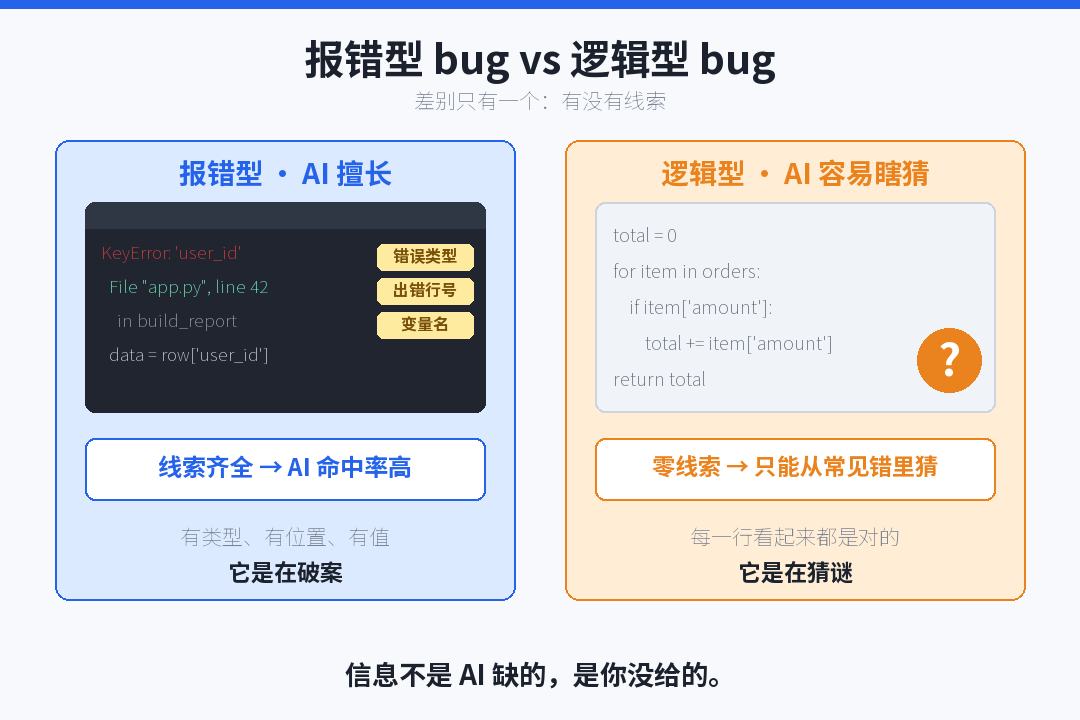
原因很简单:信息量差太多了。
| 报错型 bug | 逻辑型 bug | |
|---|---|---|
| 有没有明确信号 | 有,报错类型 + 消息 | 没有 |
| 出错位置 | 给了,精确到行 | 不知道 |
| 出错时的值 | 常常直接给出 | 完全没有 |
| AI 拿到什么 | 一份证词 | 一段”看起来都对”的代码 |
关键在最后一行。
逻辑错的代码,从语法上看每一行都是对的。
你把它丢给 AI 说”这里有 bug”,AI 只能做一件事:从常见错误清单里挑几个像的,说给你听。
要让 AI 靠谱,你必须把它缺的那部分信息补上。
二、逻辑错四件套:入、期、实、码
上一篇的报错四件套是「错、码、做、境」。
这一篇换一套:「入、期、实、码」。
| 件 | 内容 | 一句话 |
|---|---|---|
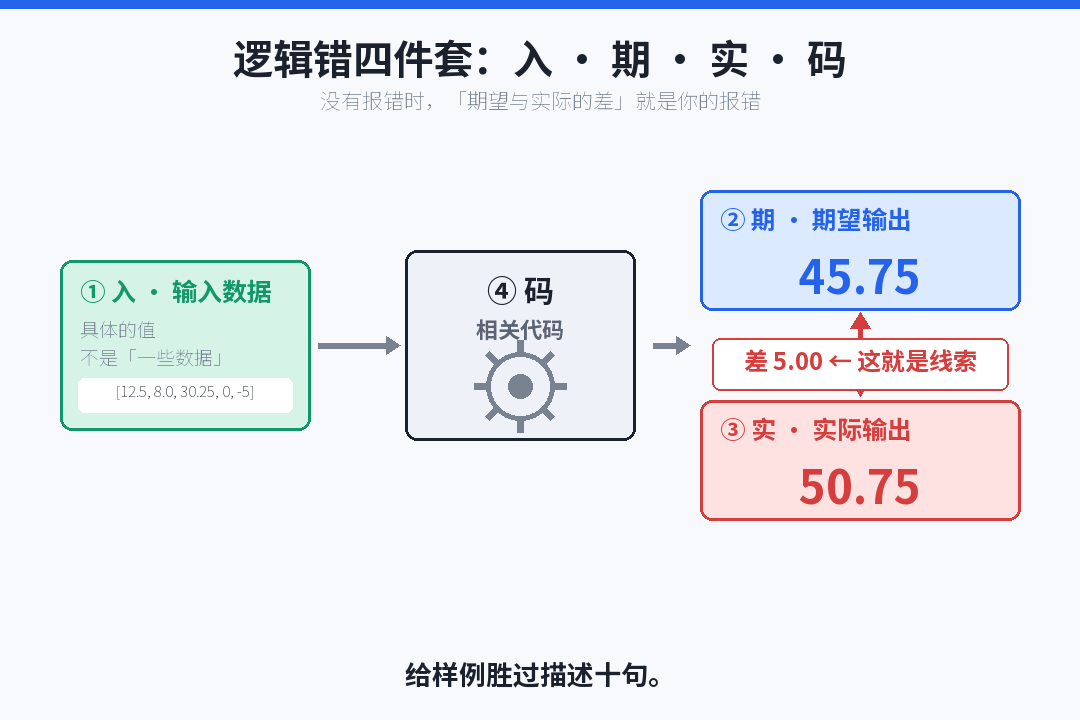
| 入 | 输入数据 | 你喂进去的具体内容 |
| 期 | 期望输出 | 你认为应该得到什么 |
| 实 | 实际输出 | 它实际给了你什么 |
| 码 | 相关代码 | 处理这段数据的代码 |
核心逻辑:既然没有报错,那唯一的线索就是「期望和实际的差异」。
这个差异越具体,AI 越能顺着差异倒推。
「入」和「实」必须是具体的值,不能是描述
这是最多人做错的地方。
❌ “我传了一些订单数据进去,结果统计不对。”
这句话对 AI 来说约等于什么都没说。
✅ “我传了 5 条订单,金额分别是 12.5、8.0、30.25、0、-5。 期望总额是 45.75,实际得到 50.75。”
看到区别了吗?
第二种写法里,那个 -5 和 0,一眼就能让 AI 想到”是不是负数/零值被过滤掉了”。
划重点:给样例胜过描述十句——在调试这里比写代码时更重要。
「期」要说清楚”为什么应该是这样”
有时候不是代码错了,是你以为的规则和实际规则不一样。
所以除了写期望值,最好补一句依据:
“期望是 45.75,因为按业务规则,负数订单(退款)也要算进总额。”
这一句能帮 AI 判断:到底是代码写错了,还是需求本来就有歧义。
三、最该学的一招:二分法定位
如果只让我教新手一个调试技巧,我会教这个。
它不需要任何工具,不需要懂调试器,笨但极其有效。
思路
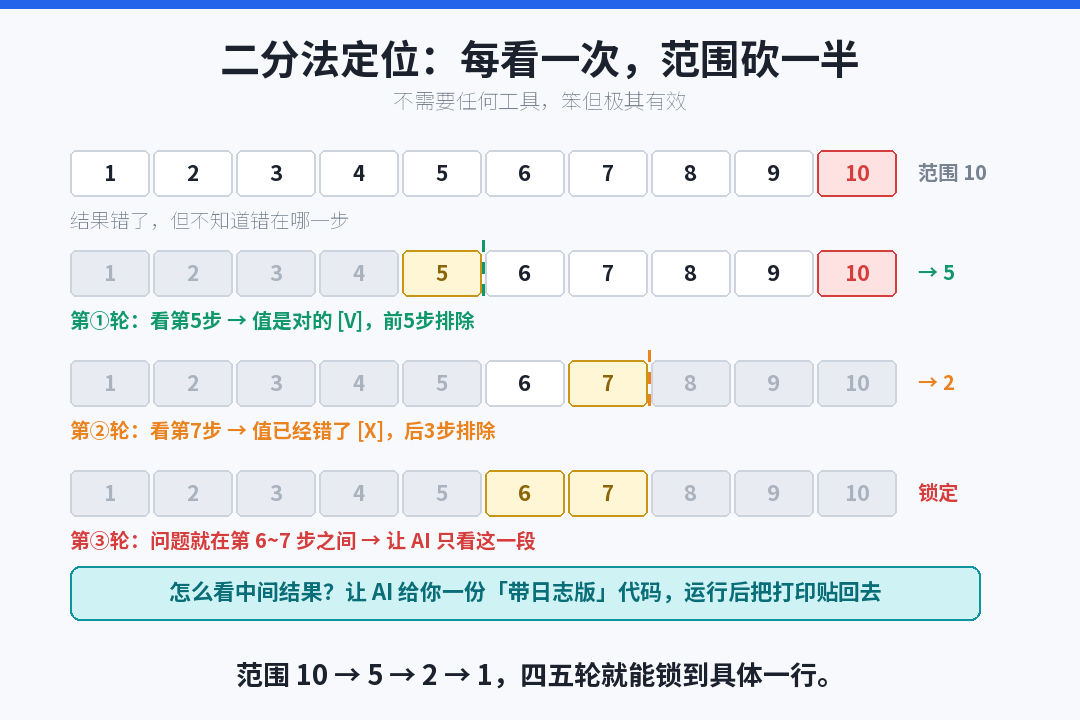
假设你的处理流程有 10 步,结果在第 10 步不对。
问题在哪一步?你不知道。
那就先看第 5 步。
- 如果第 5 步的结果已经不对了 → 问题在前 5 步,后 5 步不用看了
- 如果第 5 步的结果是对的 → 问题在后 5 步
一次操作,排查范围砍掉一半。
再来一次,砍成四分之一。四五轮之内,你能把范围缩到具体某一行。
怎么”看”中间结果?
最简单的办法:打印出来。 这事儿不用你自己写,直接让 AI 帮你加:
“请在这段代码的每个关键步骤后面加一行打印, 把当时的变量值和步骤名打出来,给我完整代码。 我运行后会把打印结果贴给你。”
然后你运行,把打印出来的那一坨复制回去。
这个来回,就是新手能做的最高效的调试动作。
为什么这招对 AI 特别有效
因为它把”猜”变成了”看”。
AI 拿到中间打印结果之后,它面对的就不再是一段”看起来都对的代码”,而是一组带具体值的现场数据。
这时候它就从”猜谜”切换回了”破案”模式。
四、别问”哪里错了”,要让 AI”逐行推演”
这是个提问方式上的大坑。
❌ “这段代码哪里有问题?”
这句话在暗示 AI”这里有问题”。
AI 为了满足你,会努力找一个问题出来——哪怕代码其实是对的。
换个问法,效果完全不同:
✅ “请假设你是计算机,逐行执行这段代码。 输入是【具体数据】。 每执行一行,写出这一行执行后所有关键变量的值。 最后告诉我程序输出是什么。 先不要看我的期望值,也不要试图找 bug,就老老实实推演。”
这叫「代码走读」,或者说”手工模拟执行”。
它的妙处在于:你没有让 AI 找 bug,你让它算一遍。
算完之后,你再对比:
“你推演出的结果是 50.75,我期望的是 45.75。 现在请指出:是哪一步导致了这个差异?”
这时候 AI 给的答案,准确率会高一大截。
因为它是从自己的推演里找矛盾,而不是凭印象猜。
五、常见逻辑错清单:让 AI 照着查一遍
有一些逻辑错误特别高频,几乎每个新手都会踩。
你可以直接让 AI 拿这张清单去对照检查。
① 差一位(边界问题)
循环少跑一次或多跑一次;取列表最后一个元素时算错位置。
典型表现:结果永远少一条 / 多一条。
② 小数比较
0.1 + 0.2 在计算机里不等于 0.3。这不是 bug,是浮点数的天性。
典型表现:金额差几分钱 / 判断相等永远不成立。
③ 复制还是引用
你以为复制了一份数据去改,其实改的是原来那份。
典型表现:改了 A,B 也跟着变了。
④ 异步顺序
网络请求还没回来,你就去用它的结果了。
典型表现:第一次是空的,刷新一下就好了。
⑤ 条件判断顺序
多个 if 条件的顺序写反了,某些数据被前面的条件先截走了。
典型表现:大部分对,少数特定数据不对。
⑥ 类型隐式转换
字符串 "10" 和数字 10 在有些语言里能直接比较,结果可能出乎意料。
典型表现:排序结果诡异(比如 10 排在 9 前面)。
⑦ 空值与零值被一起过滤
代码里写了”如果没有值就跳过”,结果把真实的 0 也当成”没有值”跳过了。
典型表现:总数偏少,且缺的都是 0 或空字符串。
⑧ 时区与编码
时间差 8 小时;中文变成乱码。
典型表现:日期对不上 / 中文显示成问号或方块。
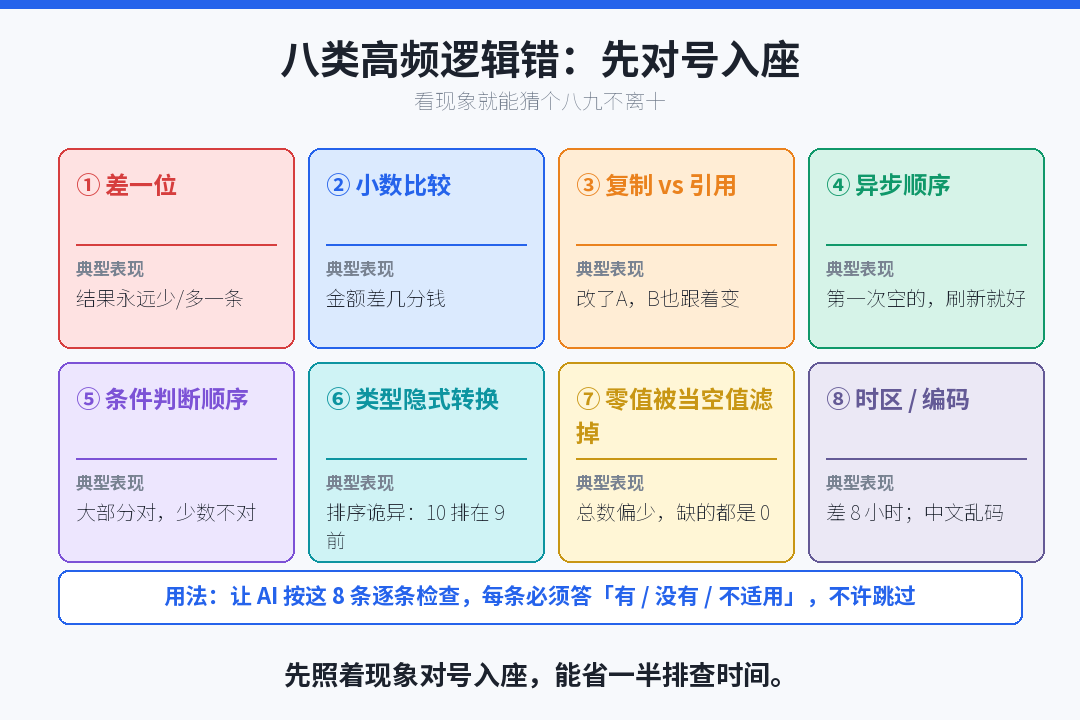
用法很简单:
“请按以下 8 类常见逻辑错误,逐条检查这段代码, 明确说明每一条’有 / 没有 / 不适用’,不要跳过。”
六、终极验证:让 AI 写测试用例来”抓”这个 bug
修完之后,怎么确认真的好了?
跑一次看起来正常,不算数。
更靠谱的做法:让 AI 写一组测试数据,专门去踩容易出问题的地方。
“请针对这个函数,设计 8 组测试输入,要求覆盖: 正常情况、空数据、只有一条、最大值、负数、零、 重复数据、以及格式不规范的数据。 每组给出输入和正确答案。”
然后你把这 8 组挨个跑一遍。
这一步经常能顺手抓出另外两三个你还不知道的 bug。
而且这组数据可以留下来——以后每次改这段代码,重跑一遍就知道有没有改坏。
七、把整个流程串起来
新手遇到”不报错但结果不对”,按这个顺序走:
| 步 | 动作 | 目的 |
|---|---|---|
| ① | 凑齐入、期、实、码四件套 | 给足信息 |
| ② | 先对八类高频错照一遍现象 | 碰运气,命中就省事 |
| ③ | 让 AI 加打印,运行,贴回结果 | 把”猜”变成”看” |
| ④ | 按二分法缩小范围 | 定位到具体几行 |
| ⑤ | 让 AI 逐行推演(先别提期望值) | 拿到中立判断 |
| ⑥ | 对比推演结果与期望,问差异出在哪一步 | 锁定根因 |
| ⑦ | 让 AI 写测试用例验证 | 确认真修好了 |
大部分逻辑 bug,走不到第五步就解决了。
提示词模板盒子
以下模板可直接复制使用,把【】里的内容换成你自己的。
模板 72-1:逻辑错四件套(万能主模板)
我的程序没有任何报错,但运行结果不对,需要你帮我定位。

【① 入 —— 输入数据】
(给出具体的值,不要用"一些数据"这种描述)

【② 期 —— 我期望的输出】
期望结果:
为什么应该是这样:(说明业务规则或计算依据)

【③ 实 —— 实际的输出】
实际结果:
差异在哪:(例如"总数少了 3 条""金额多了 5.00")

【④ 码 —— 相关代码】
(粘贴处理这段数据的完整代码)

补充:什么情况下结果是对的:(如果有)

请按顺序回答:
1. 你判断问题最可能出在哪一段?为什么
2. 我该怎么验证你的判断(要具体到我该做什么)
3. 确认后给出修改的完整代码

我是编程新手,请用大白话解释。
▸ 八类高频错筛查:让 AI 按 8 类常见逻辑错逐条回答”有 / 没有 / 不适用”,对”有”的指明行号与改法(原 72-5)。 ▸ 规则歧义排查:附上你理解的规则,让 AI 对比代码实际执行的规则,指出不一致处(原 72-7)。
模板 72-2:加打印做二分定位
这段代码的最终结果不对,但中间过程我看不到。

请给我一份"带日志版"的完整代码:
- 在每个关键步骤后面加一行打印
- 打印内容包括:步骤编号、步骤在干什么、当时关键变量的值
- 如果处理的是列表,请同时打印它的长度
- 打印格式要清晰,便于我复制回来给你看

不要改动原有逻辑,只加打印。

原代码:
【粘贴】
▸ 生成测试用例:让 AI 设计覆盖正常 / 空 / 边界 / 异常的输入组,改完挨个验证(原 72-6)。
模板 72-3:逐行推演(中立问法,防附和)
请你扮演一台计算机,逐行执行下面这段代码。

输入数据是:【具体的值】

要求:
- 一行一行来,不要跳步
- 每执行一行,写出这一行执行后所有关键变量的当前值
- 遇到循环,至少完整展示前两轮和最后一轮
- 最后给出程序的最终输出

重要:现在不要试图寻找 bug,也不要评价代码好坏,
就老老实实按代码写的逻辑推演一遍。

代码:
【粘贴】
▸ 对比差异找根因:把推演结果与期望值并排,追问差异从第几步产生、是代码错还是理解偏差(原 72-4)。
速查:两类 bug,两套四件套
| 报错型(第71篇) | 逻辑型(本篇) | |
|---|---|---|
| 四件套 | 错、码、做、境 | 入、期、实、码 |
| 核心线索 | 报错原文 + 栈 | 期望与实际的差异 |
| 关键动作 | 找栈里自己的文件名 | 加打印 + 二分法 |
| 最大的坑 | 红字消失≠修好 | AI 顺着你说”是的这里有问题” |
| 验收标准 | 说得清值为什么变成那样 | 测试用例全部通过 |
最后
这一篇的核心,也压缩成一句话:
没有报错的时候,”期望和实际的差”就是你的报错。
把这个差描述得越具体,AI 越派得上用场。
而当你连差异都描述不清楚的时候——先别急着问 AI,先加两行打印。
看见了,才谈得上分析。
下篇预告
第73篇《用 AI 做性能瓶颈分析——慢在哪,它告诉你》。 能跑、结果也对,就是慢——比 bug 更无从下手。下一篇讲先量再改、性能四大元凶,以及反直觉真相:拖慢你的往往不是代码,是它问了数据库一百遍。我们下篇见。