能跑,结果也对,就是慢得让人想砸键盘。
前两篇讲”错”,这一篇讲”慢”。
这两件事完全不是一回事。
Bug 是有答案的:要么报错了,要么结果不对,改完一验证,对了就是对了。
慢没有答案。
页面点一下转圈五秒,导出一个表要等半分钟,数据一多就整个卡死——它不报错,它也没算错,它只是让你等。
更难受的是:你连”多快才算正常”都说不上来。
于是很多新手的操作是这样的:
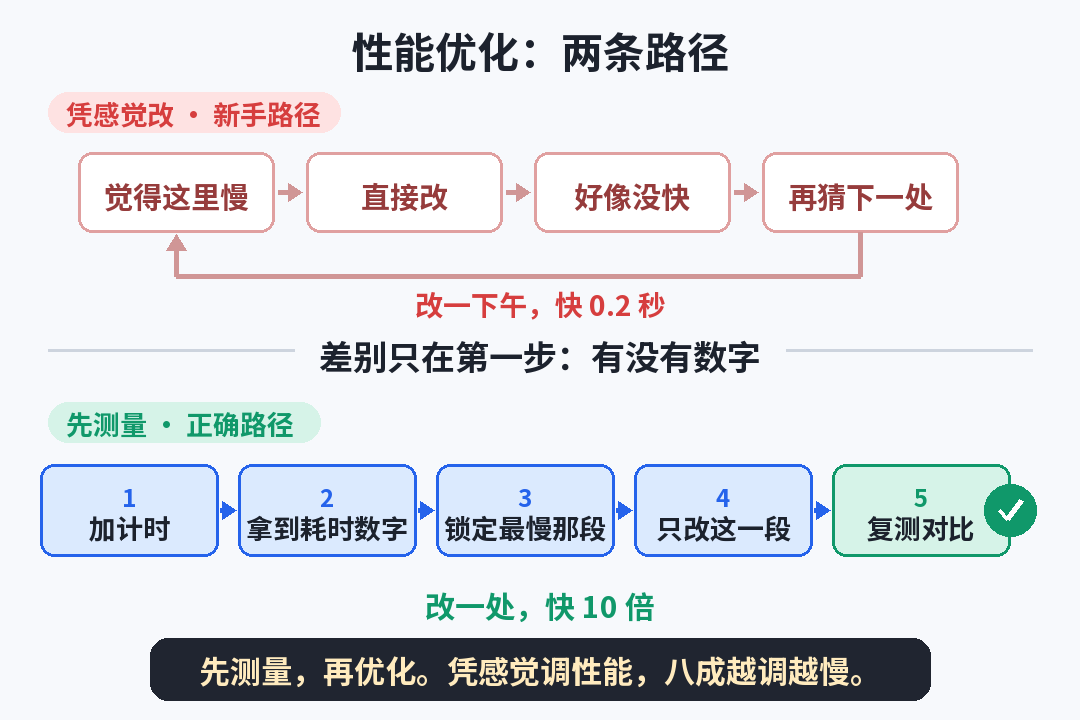
觉得这段循环可能有点慢 → 改了 → 好像还是那么慢 → 又觉得那个查询有问题 → 再改 → 更慢了
改了一下午,快了 0.2 秒,还顺手改出两个新 bug。
这一篇我们把打法讲清楚。核心就一句:
先测量,再优化。凭感觉调性能,八成越调越慢。
一、新手最大的坑:跳过测量,直接动手
先说一个真实到扎心的规律:
你觉得慢的那段代码,十有八九不是真正慢的那段。
人对”哪里慢”的直觉极其不准。看起来很复杂的一段计算,可能只花了 3 毫秒;看起来平平无奇的一行取数据,可能花了 4 秒。
而 AI 呢?你不给它数据,它比你更爱猜。
你把 200 行代码丢过去说”这段有点慢,帮我优化”,AI 一定会给你一堆看起来很专业的建议:
- “可以考虑使用缓存”
- “建议改成异步处理”
- “这里可以用更高效的数据结构”
每一条听起来都对。每一条都可能跟你的实际瓶颈毫无关系。
因为 AI 在做的事,和你一样——猜。
所以性能优化的第一步,从来不是”问 AI 怎么优化”,而是:
先让 AI 教你怎么量,量出数字,再拿数字问它。
二、不用专业工具,三招量出耗时
一提”性能分析”,很多教程立刻上性能剖析器、火焰图、监控平台。
对小白来说那太远了。先用最土的三招就够,土归土,管用。
第 1 招:整体计时——先确认到底有多慢
在这段功能开始前和结束后各记一个时间,相减打印出来。
这一步的意义是:把”感觉慢”变成”3.8 秒”。
数字一出来,讨论才有基础。
第 2 招:分段计时——把大块切成小块
这是最关键的一招。
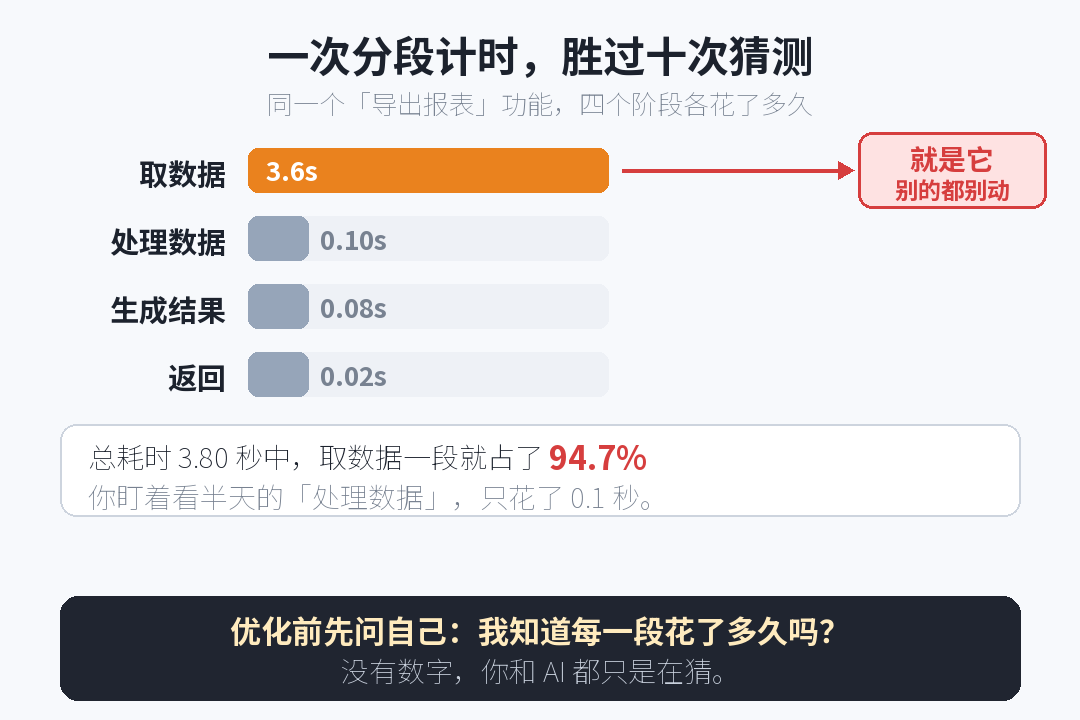
把整个流程拆成 3~5 段(比如:取数据 / 处理数据 / 生成结果 / 返回),每段都记一次耗时。
跑一次,你会看到类似这样的结果:
| 阶段 | 耗时 |
|---|---|
| 取数据 | 3.6 秒 |
| 处理数据 | 0.1 秒 |
| 生成结果 | 0.08 秒 |
| 返回 | 0.02 秒 |
答案瞬间就有了。
你之前盯着看了半天的”处理数据”那段复杂逻辑,只占 0.1 秒。真正的问题在取数据。
这一张表,比你问 AI 十遍都有用。
第 3 招:改数据量——看它是不是”越多越慢”
同一个功能,分别用 10 条、100 条、1000 条数据各跑一次,记下耗时。
- 10 条 0.1 秒,100 条 1 秒,1000 条 10 秒 → 和数据量成正比,属于正常,但有优化空间
- 10 条 0.1 秒,100 条 10 秒,1000 条直接卡死 → 危险信号,说明数据一多耗时暴涨,多半是”循环里套查询”或”循环里套循环”
- 10 条 3 秒,1000 条也 3 秒 → 慢的不是数据处理,是某个固定开销(比如某次网络请求、某个初始化)
这三种情况的解法完全不同。分不清就乱改,必然白干。
三、性能四件套:作、量、时、标
有了数字,才轮到 AI 上场。
问性能问题,和问 bug 一样,要给四样东西。这一套记住:作、量、时、标。
1)作——是哪个操作慢
不要说”我系统慢”。要说”点击『导出报表』按钮之后慢”。
具体到一个用户动作。
2)量——数据规模多大
“表里有 5 万条记录,这次导出筛出 2000 条。”
数据量是性能问题的第一上下文。 不给数据量,AI 给的建议全是空话。
3)时——实测耗时,最好是分段的
把你第 2 招量出来的那张表直接贴给它。
4)标——你的目标是多快
“希望 3 秒内出来” 和 “希望 100 毫秒内出来”,是两个量级的方案。
前者可能加个索引就行,后者可能要上缓存、改架构。不说目标,AI 容易给你一个杀鸡用牛刀的方案。
把这四样凑齐,AI 的回答质量会立刻从”正确的废话”变成”能落地的建议”。
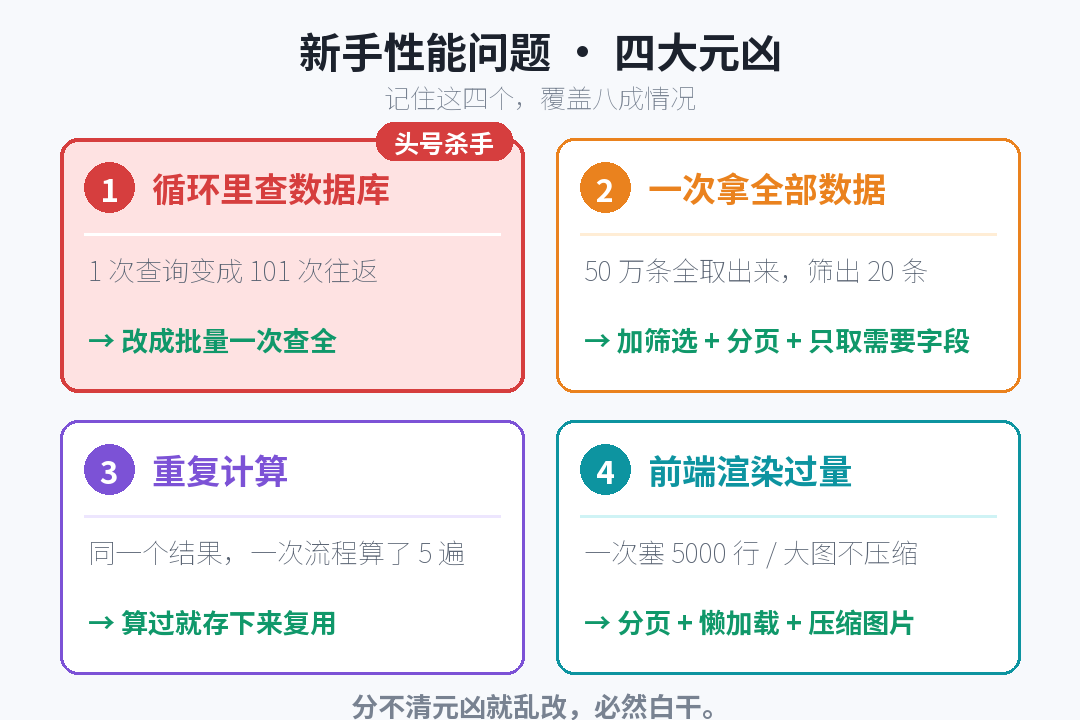
四、新手性能问题的四大元凶
看了大量新手代码之后,你会发现慢的原因高度集中。记住这四个,覆盖八成情况。
元凶一:在循环里查数据库(头号杀手)
这是最常见、也是最致命的一个。
代码逻辑通常长这样:
先查出 100 个订单 → 然后对每个订单,再去查一次它的客户信息
看起来很自然对吧?但实际发生的事情是:
1 次查询 + 100 次查询 = 101 次数据库往返。
每次往返哪怕只要 30 毫秒,101 次就是 3 秒多。
这就是那个反直觉的事实:真正拖慢你的不是代码,是它问了数据库一百遍。
正确做法是一次性把 100 个客户全查出来,再在内存里对应上。101 次变 2 次,3 秒变 60 毫秒。
你不需要会写这个优化,你只需要知道去问 AI:「我这段是不是在循环里查数据库?能不能改成批量查询?」
元凶二:一次性把全部数据拿出来
“查询所有订单” —— 表里有 50 万条,你全拿了出来,然后在代码里筛出 20 条显示。
该让数据库干的活,你搬到内存里干了。
三个关键词:
- 加筛选条件
- 加分页
- 只取需要的字段
元凶三:重复计算同一个东西
同一个结果,在一次流程里算了 5 遍;同一份配置,每次调用都重新读一次文件。
算过的东西存下来复用,这就是缓存最朴素的含义。
元凶四:前端一次性渲染太多东西
一次往页面上塞 5000 行表格、几十张没压缩的大图,浏览器直接卡住。
解法:
- 分页
- 懒加载
- 图片压缩
五、让 AI 改的时候,守住三条线
拿到 AI 的优化建议后,别一口气全改了。 性能优化最容易的翻车方式,就是”快了,但结果不对了”。
三条线,每次都守住:
第一条:一次只改一处,改完立刻测。
同时改三处,快了你不知道是哪处起的作用,慢了你也不知道该退哪一步。
第二条:改之前留副本。
原来的代码整段复制到一个备份文件里。优化改坏的概率,比你想的高。
第三条:改完必须核对结果一致。
这是最容易被忽略、后果最严重的一条。
优化的前提是”结果不变,只是更快”。而很多优化写法(尤其是批量查询、加缓存)极容易悄悄改变结果:少了几条数据、顺序变了、拿到的是旧数据。
所以每次优化后,必须拿同一份输入跑一遍,逐条对比新旧结果。
快了但结果错了,比慢着但对着糟糕得多。
六、一个完整的实战节奏
把上面的东西串起来,一次完整的性能优化长这样:
- 描述现象 —— 点导出按钮,等 8 秒
- 整体计时 —— 确认是 7.9 秒,不是错觉
- 分段计时 —— 取数据 7.5 秒,其余加起来 0.4 秒
- 变数据量再测 —— 100 条 0.8 秒,1000 条 7.5 秒,成正比且偏慢
- 凑齐四件套问 AI —— 作、量、时、标一次说清
- AI 判断 —— 循环里逐条查客户信息,典型 N+1
- 只改这一处 —— 改成批量查询,留好备份
- 复测 —— 7.9 秒 → 0.6 秒
- 对结果 —— 导出条数、内容、顺序与优化前完全一致 ✔
九步走完,比瞎改一下午强一百倍。
注意第 9 步不能省。没对过结果的优化,不算完成。
提示词模板盒子
以下模板可直接复制使用,把方括号里的内容替换成你自己的情况。
模板一:让 AI 教你加计时(第一步永远是这个)
我要给下面这段代码做性能分析,但我不知道慢在哪。

请你帮我做两件事:
1. 把这段流程拆成 3~5 个阶段,在每个阶段前后加上计时代码,
   运行后能打印出每段各花了多少毫秒。
2. 计时代码请加得明显一点(加注释标出来),方便我之后删掉。

要求:
- 只加计时,不要改动任何原有逻辑
- 给我完整文件,不要片段
- 最后告诉我:运行后我应该重点关注哪几个数字

代码如下:
[粘贴你的代码]
▸ 数据量增长测试解读:把 10/100/1000 条各跑一次的耗时贴给 AI,让它判断是”成正比 / 暴涨 / 几乎不变”,并指出下一步先查哪段(原模板四)。
模板二:性能四件套——正式提问(核心模板)
我有一个性能问题,信息如下:

【作】慢的操作:[例如:点击"导出订单报表"按钮]
【量】数据规模:[例如:订单表 5 万条,本次筛出 2000 条]
【时】实测耗时(分段):
  - 取数据:3.6 秒
  - 处理数据:0.1 秒
  - 生成文件:0.08 秒
  - 总计:3.8 秒
【标】目标:希望总耗时降到 1 秒以内

相关代码如下:
[粘贴最慢那一段的代码]

请你:
1. 先判断瓶颈最可能出在哪一行或哪几行,说明理由
2. 给出优化方案,按"见效大小"排序,并标出每个方案的风险
3. 先只给我改动最小、见效最大的那一个方案的完整代码
4. 告诉我改完之后,我应该怎么验证"结果没变,只是变快了"

不要一次给我多个方案的代码,我要一个一个改。
▸ 优化后安全核对:改完让 AI 列一份可勾选清单——对比哪几项确认”结果没变”,以及这种优化最易在什么边界悄悄出错(原模板五)。
模板三:排查”循环里查数据库”(头号元凶专用)
请检查下面这段代码,是否存在"在循环里反复查询数据库"的问题
(也就是常说的 N+1 查询)。

请按以下格式回答:
1. 有没有:是 / 否
2. 如果有,指出是哪一个循环、循环里的哪一行在查询
3. 按当前数据量估算:总共会产生多少次数据库查询
4. 改成批量查询后,查询次数会变成多少
5. 给出改造后的完整代码

特别注意:改造后必须保证返回的数据条数、内容、顺序
与原来完全一致。如果有可能不一致,请提前告诉我。

代码如下:
[粘贴你的代码]
速查卡:性能优化五句口诀
1. 先量再改  —— 没有数字,不要动代码
2. 分段计时  —— 一张耗时表,胜过十次猜
3. 四件套    —— 作(什么操作)、量(多少数据)、时(多久)、标(目标)
4. 一次一处  —— 改完立刻测,别批量改
5. 必对结果  —— 快了但错了,比慢着更糟
最后
这一篇的核心,压缩成一句话:
性能问题里,”数字”就是你的报错。
Bug 有红字告诉你出事了,性能没有。那个数字,就是你自己造出来的红字。
没有它,你和 AI 都在猜;有了它,路径只剩一条。
先测量,再优化。 记住这五个字,你已经甩开一半的人了。
下篇预告
第74篇《用 AI 理解遗留老代码——接手祖传项目不慌》。 代码不是你写的、写的人离职了、没文档没注释几千行起步。下一篇讲:按什么顺序读(九成人一上来就开错文件)、怎么让 AI 画”项目地图”、以及动手前先查清”这一行被谁用着”。不懂全部,也能安全改动。 我们下篇见。